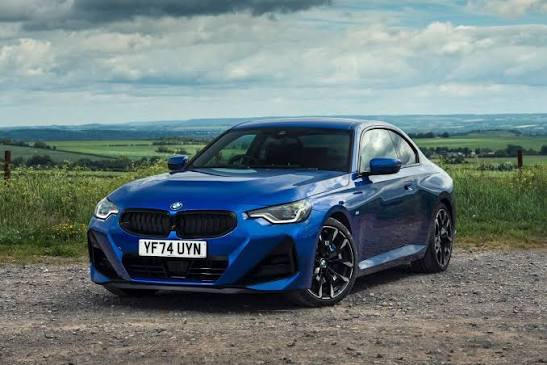
BMW 2 SERIES · 研究方法與成果
流程與方法
研究資料
以 11 種車型建立影像資料與辨識類別。
車型世代與車身形式
F44、G42、U06 等代號用於區分車型世代或平台;218i、220i 等則代表不同版本。本研究同時考量車身形式與外觀細節,建立細分類辨識的研究範圍。
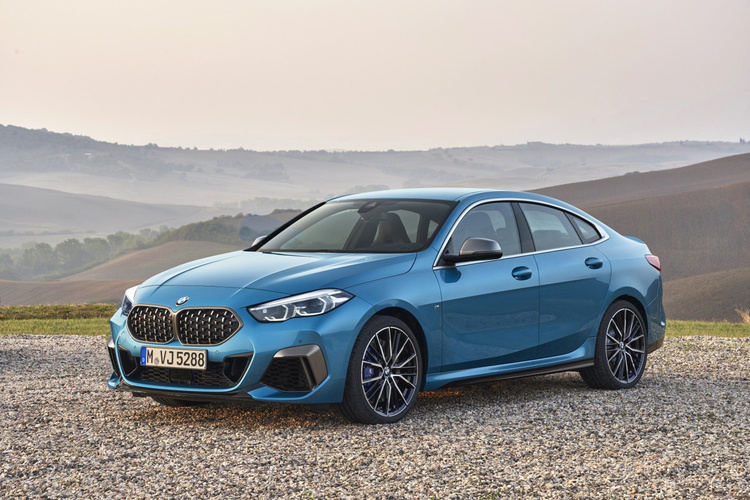
F44 · Gran Coupé
四門轎跑。外觀接近的 218i、220i、M235i,是細分辨識的挑戰。
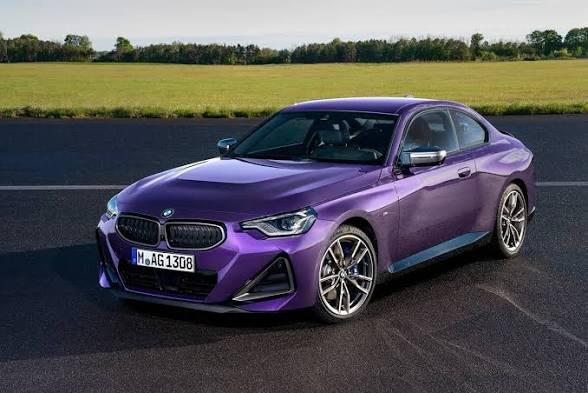
G42 · Coupé
雙門轎跑。220i、230i、M240i 在外觀上仍有許多相似線索。
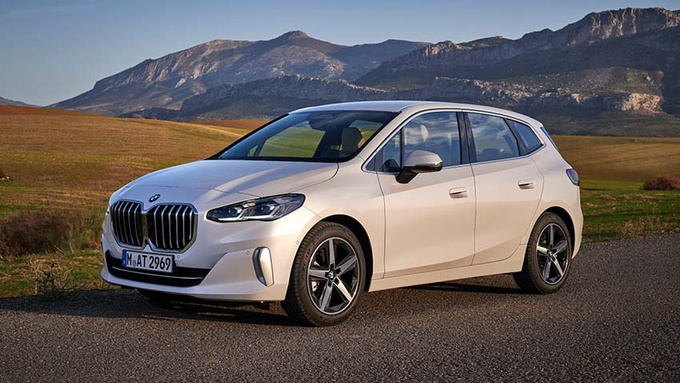
U06 · Active Tourer
車身較高的多功能車。研究範圍包括 218i、220i、230e。
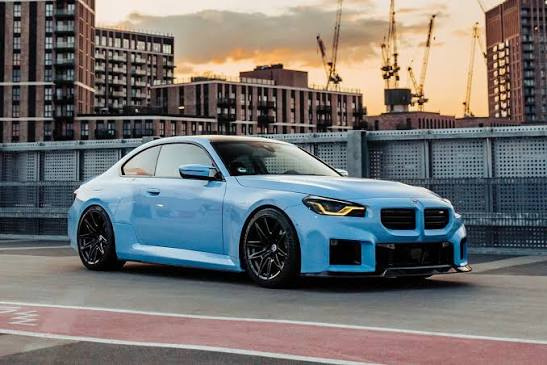
F87 / G87 · M2
M2 高性能雙門車款。M 車款是性能分類,並不是另一種車身形式。
辨識類別與資料配置
| 編號 | 車型 | 車身形式 | 訓練 | 驗證 |
|---|---|---|---|---|
| 0 | F44 220i Gran Coupé | 四門轎跑 | 150 | 30 |
| 1 | F44 218i Gran Coupé | 四門轎跑 | 150 | 30 |
| 2 | F44 M235i xDrive Gran Coupé | 四門轎跑 | 150 | 30 |
| 3 | F87 M2 | 高性能雙門轎跑 | 150 | 30 |
| 4 | G42 230i Coupé | 雙門轎跑 | 150 | 30 |
| 5 | U06 218i Active Tourer | 多功能車 | 150 | 30 |
| 6 | G42 M240i xDrive Coupé | 雙門轎跑 | 150 | 30 |
| 7 | U06 230e xDrive Active Tourer | 多功能車 | 150 | 30 |
| 8 | G42 220i Coupé | 雙門轎跑 | 150 | 30 |
| 9 | G87 M2 | 高性能雙門轎跑 | 150 | 30 |
| 10 | U06 220i Active Tourer | 多功能車 | 150 | 30 |
影像品質與資料限制
類別分布與影像多樣性
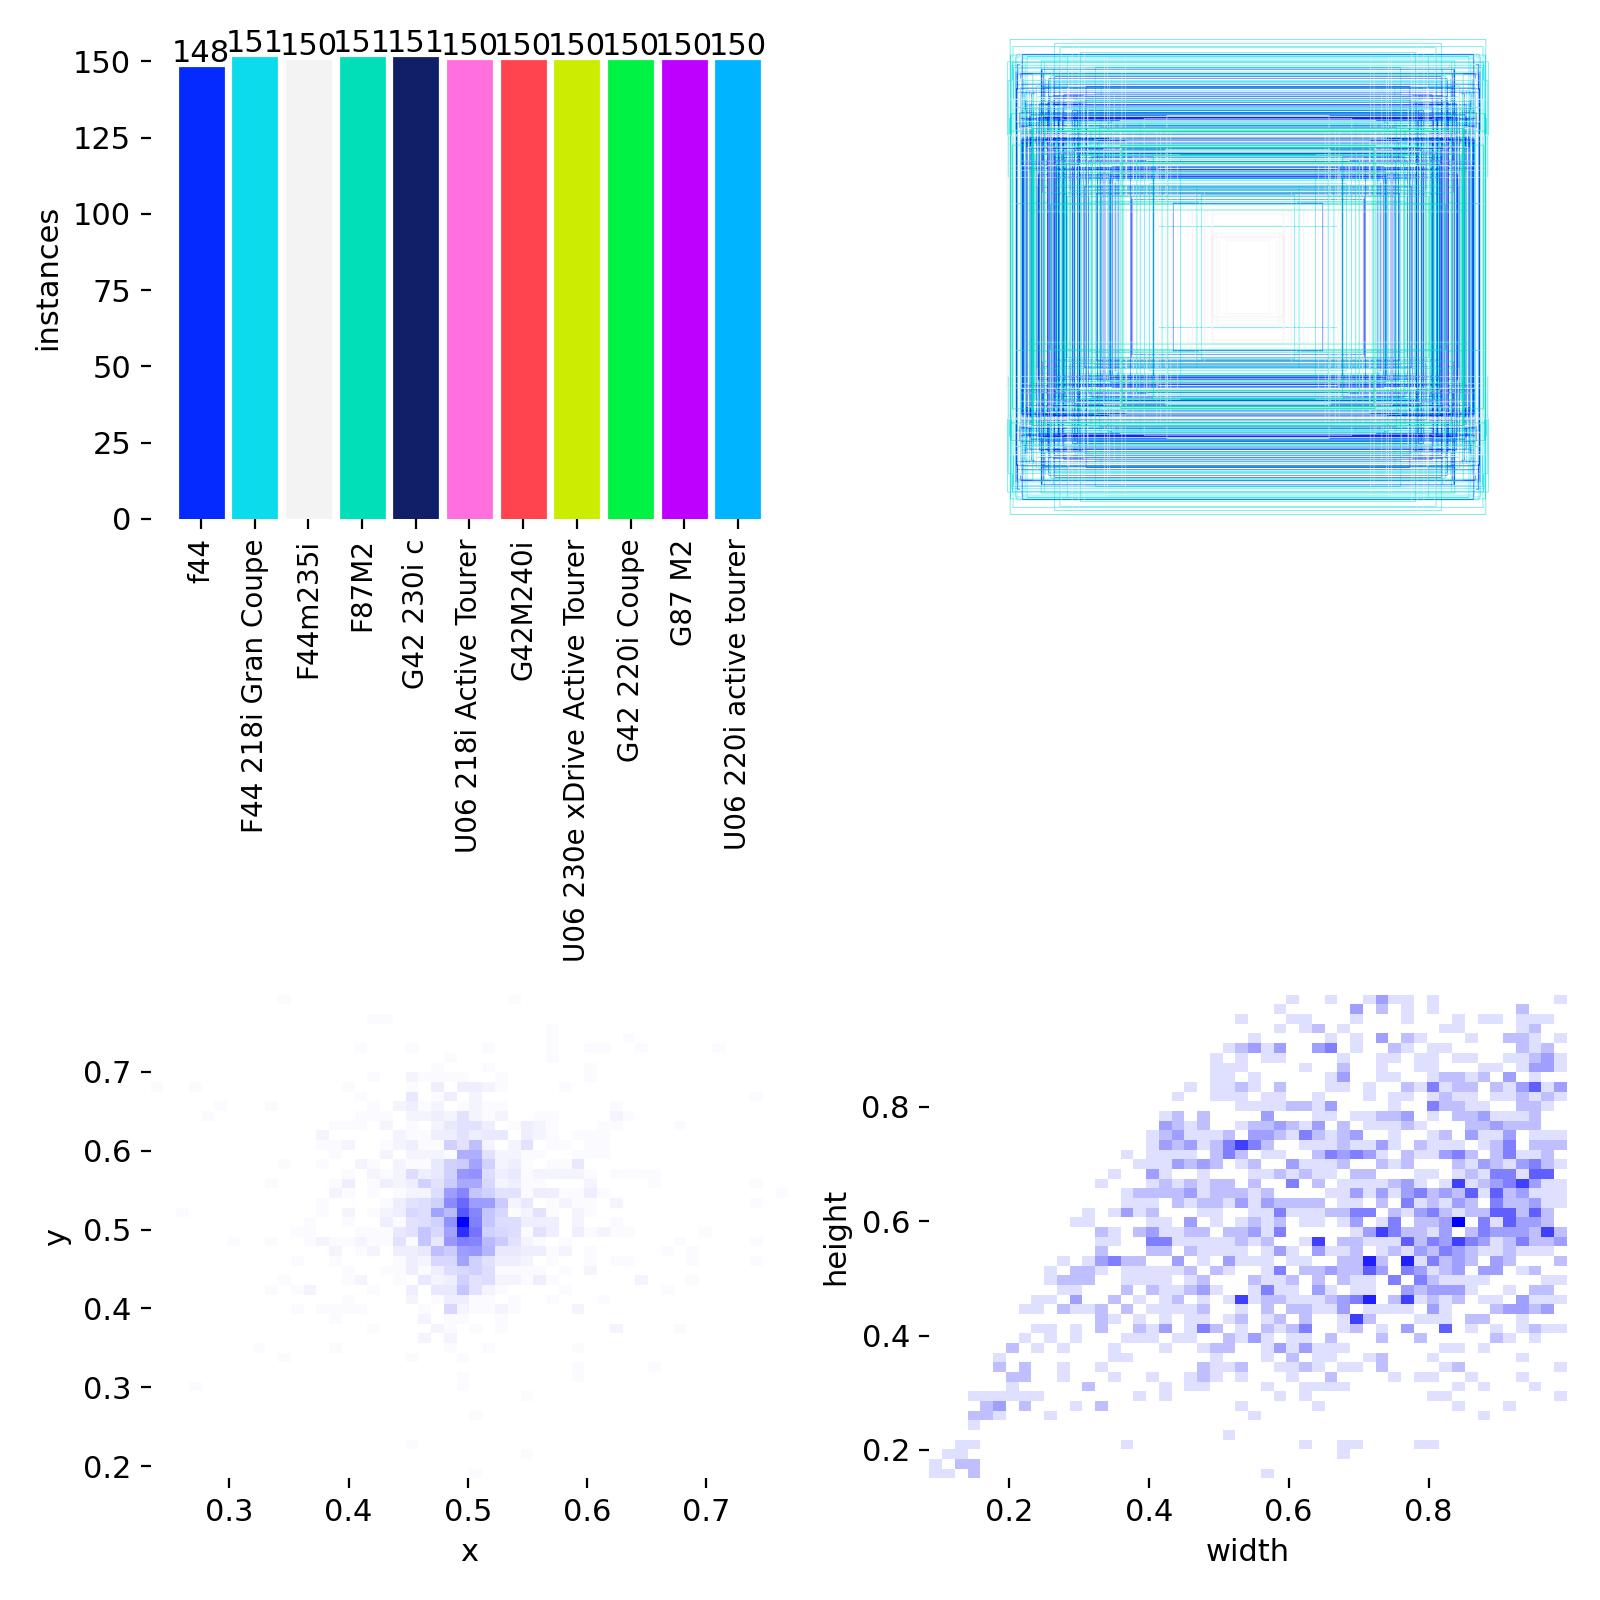
報告的各類標註框數約為 148–151,分布接近平均;但車輛多位於照片中央,構圖也較集中。
資料構圖較集中,可能影響模型對側面視角、遮擋、模糊影像與複雜背景的辨識穩定性。
後續可增加不同顏色、角度、光線與距離的照片,並統一標註品質。
資料分組與評估設計
訓練集(Training Set)
提供影像與標註資料,供模型學習車輛位置及車型特徵。
驗證集(Validation Set)
用於觀察訓練成效與比較設定,檢查模型在未參與參數更新的資料上的表現。
測試集(Test Set)
保留未參與訓練與設定調整的影像,評估模型對新資料的辨識能力。
影像標註
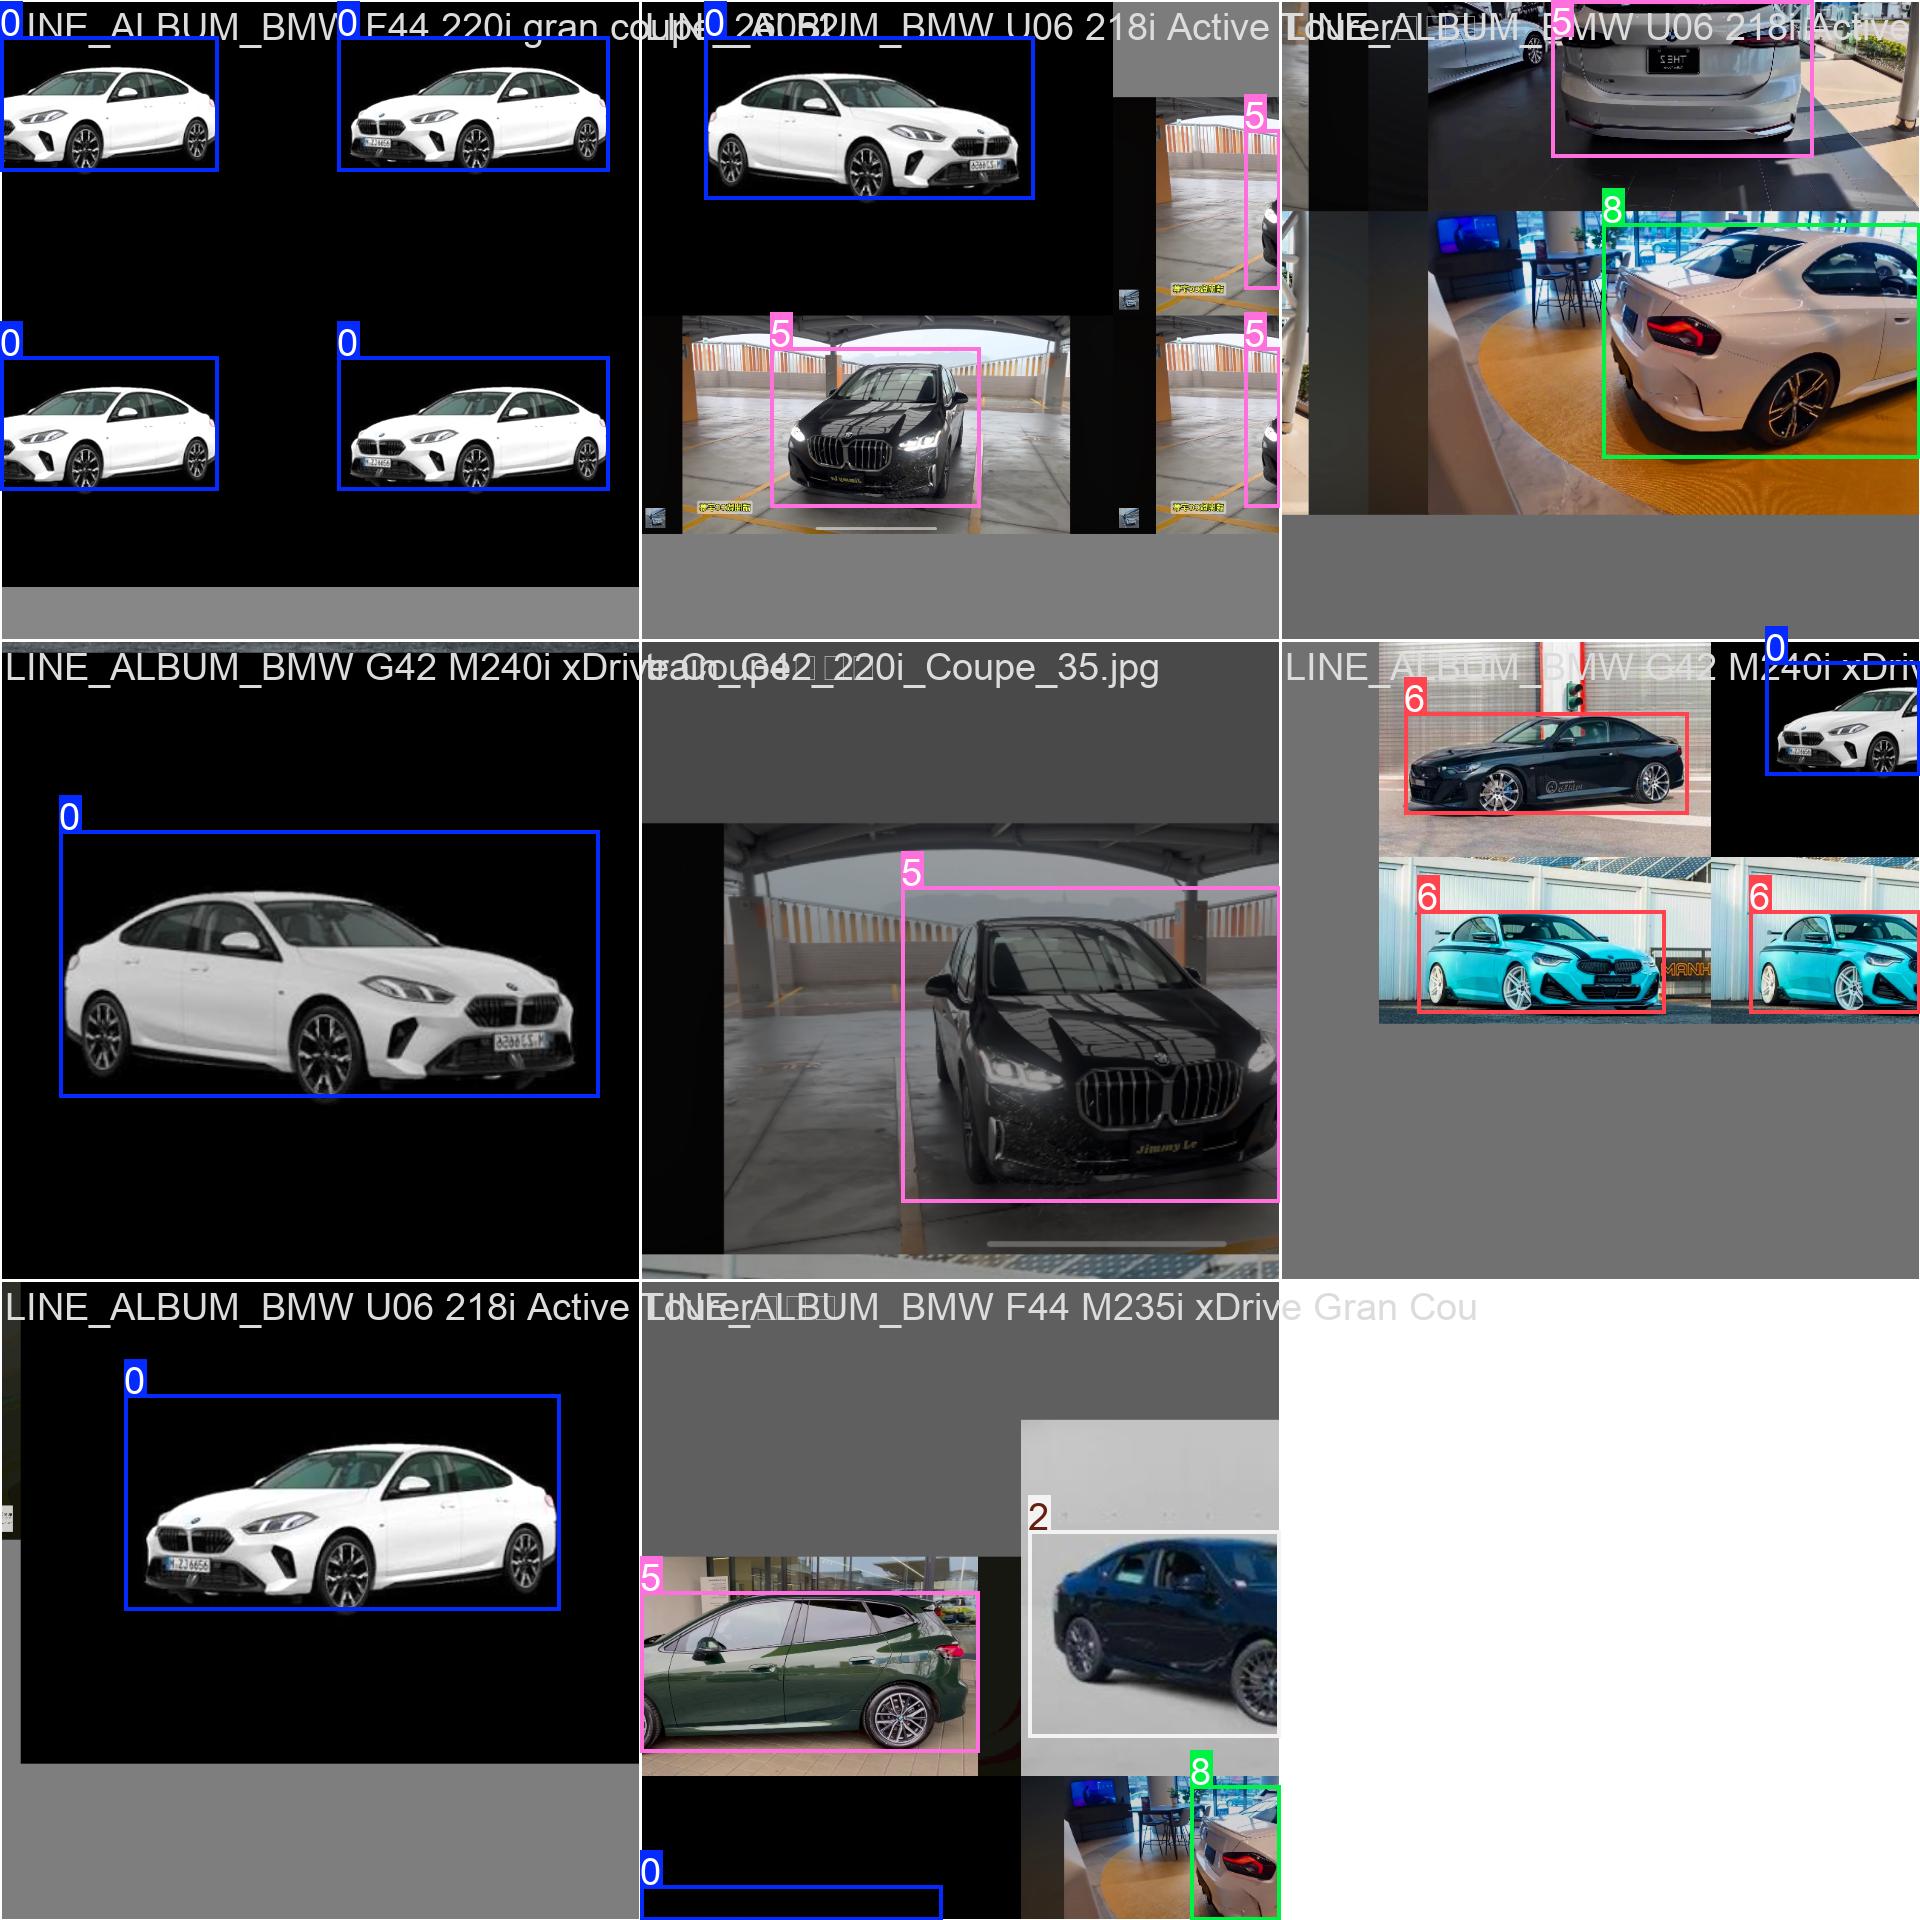
以邊界框與類別標籤建立模型訓練所需的影像標註。
標註內容與規則
每張影像需記錄車輛所在位置與對應車型,作為模型訓練的標準資料。
邊界框與類別設定
本研究使用 LabelImg 框選完整車輛,並指定對應的車型類別,例如 F44 220i Gran Coupé。
車輛框選範圍稱為邊界框(Bounding Box),車型標籤則稱為類別(Class)。模型依據兩項標註學習定位與分類。
標註作業流程
圖片分類與載入
先按車型整理照片,再開啟要標註的圖片。
標註格式設定
輸出文字標註檔,並確認所有圖片使用相同的類別順序。
車輛範圍框選
盡量涵蓋整台車,避免框入過多背景或漏掉車身。
車型類別指定
根據照片來源確認車型資訊,再選擇對應類別,避免僅憑外觀推定動力等級。
標註儲存與品質檢查
圖片與標註檔需使用對應檔名,並檢查類別、框選範圍是否一致。
YOLO 標註格式
YOLO 標註檔的每一行記錄一台車,包含類別編號、中心位置與框的大小。
類別編號  中心 x  中心 y  寬度  高度
0         0.50    0.50    0.70  0.60
上列數字是格式教學示例,不是專題圖片的實際標註。位置與大小會換算成圖片寬、高的比例。
標註欄位定義
- 類別編號
- 以 0 開始,對應資料介紹中的車型順序。
- 中心 x / y
- 車輛框的中心在圖片中的相對位置。
- 寬度 / 高度
- 框占整張圖片寬度與高度的比例。
模型訓練
透過影像與標註資料學習車輛位置及車型特徵。
物件偵測與車型分類
車輛定位與類別預測
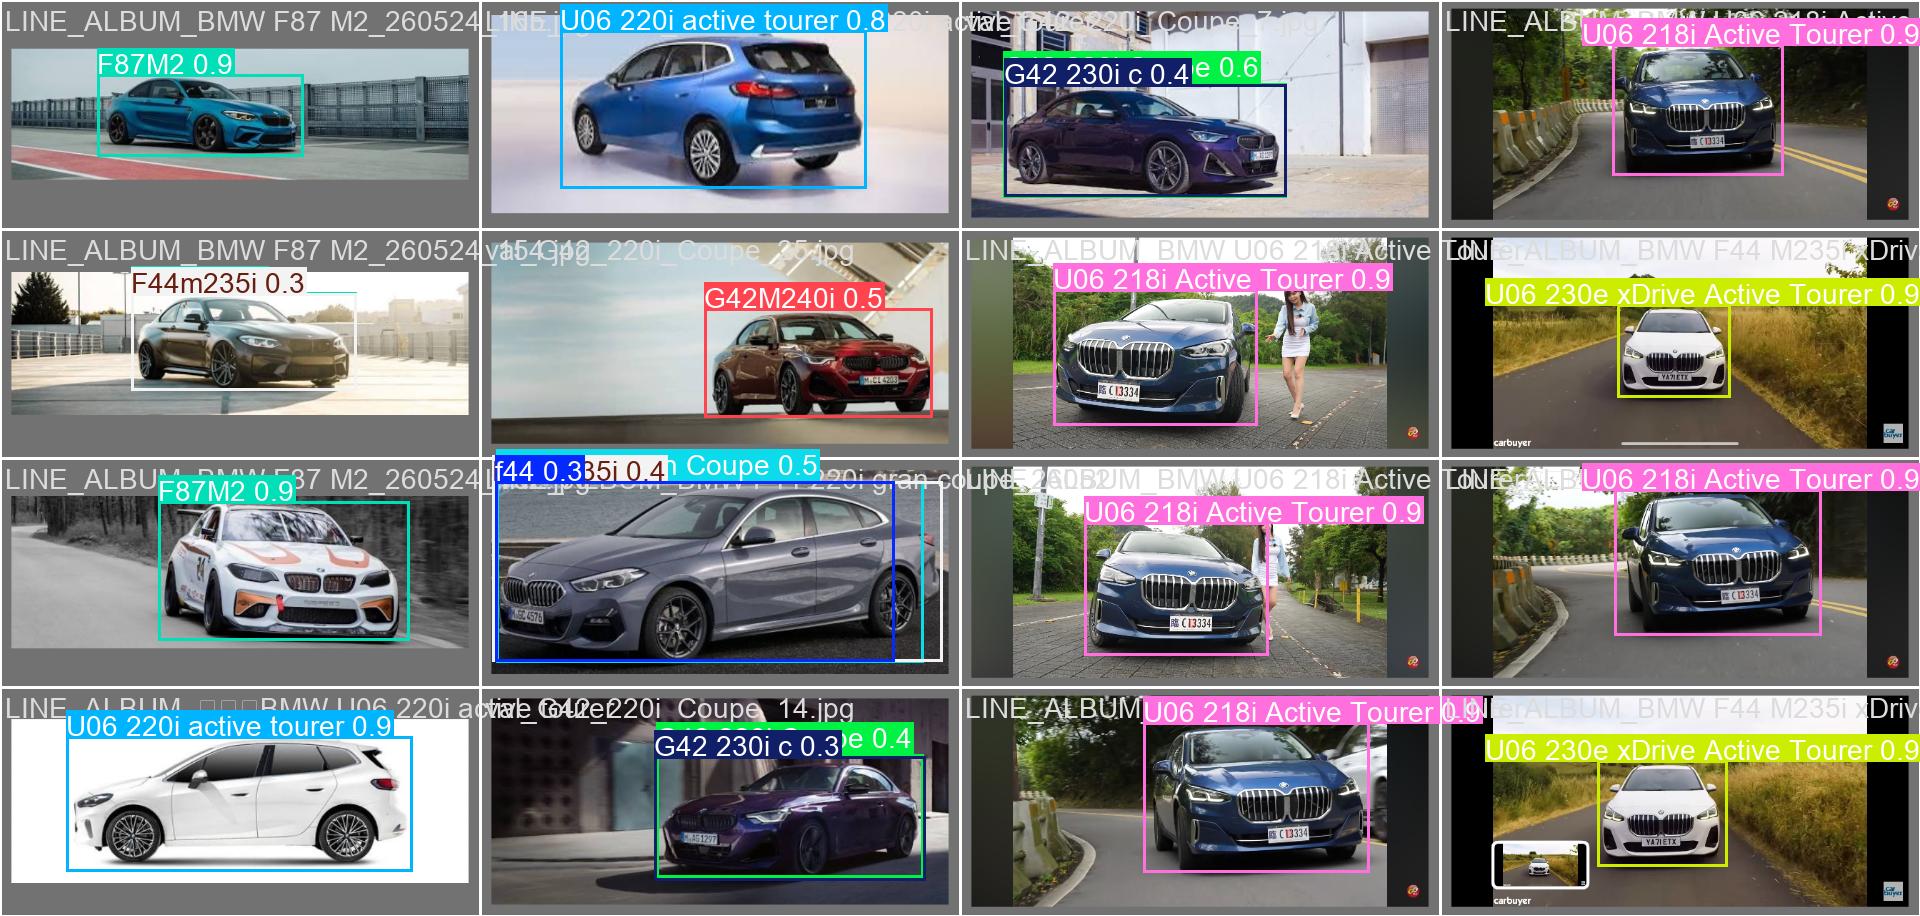
YOLO 是一種物件偵測模型。輸入一張照片後,模型會產生車輛位置、類別與信心分數。
本研究設定 11 個辨識類別,分別對應研究範圍內的 BMW 2 Series 車型。
信心分數呈現模型對偵測結果的評分,並不等同於車型辨識準確率。
模型訓練機制
預測誤差與參數調整
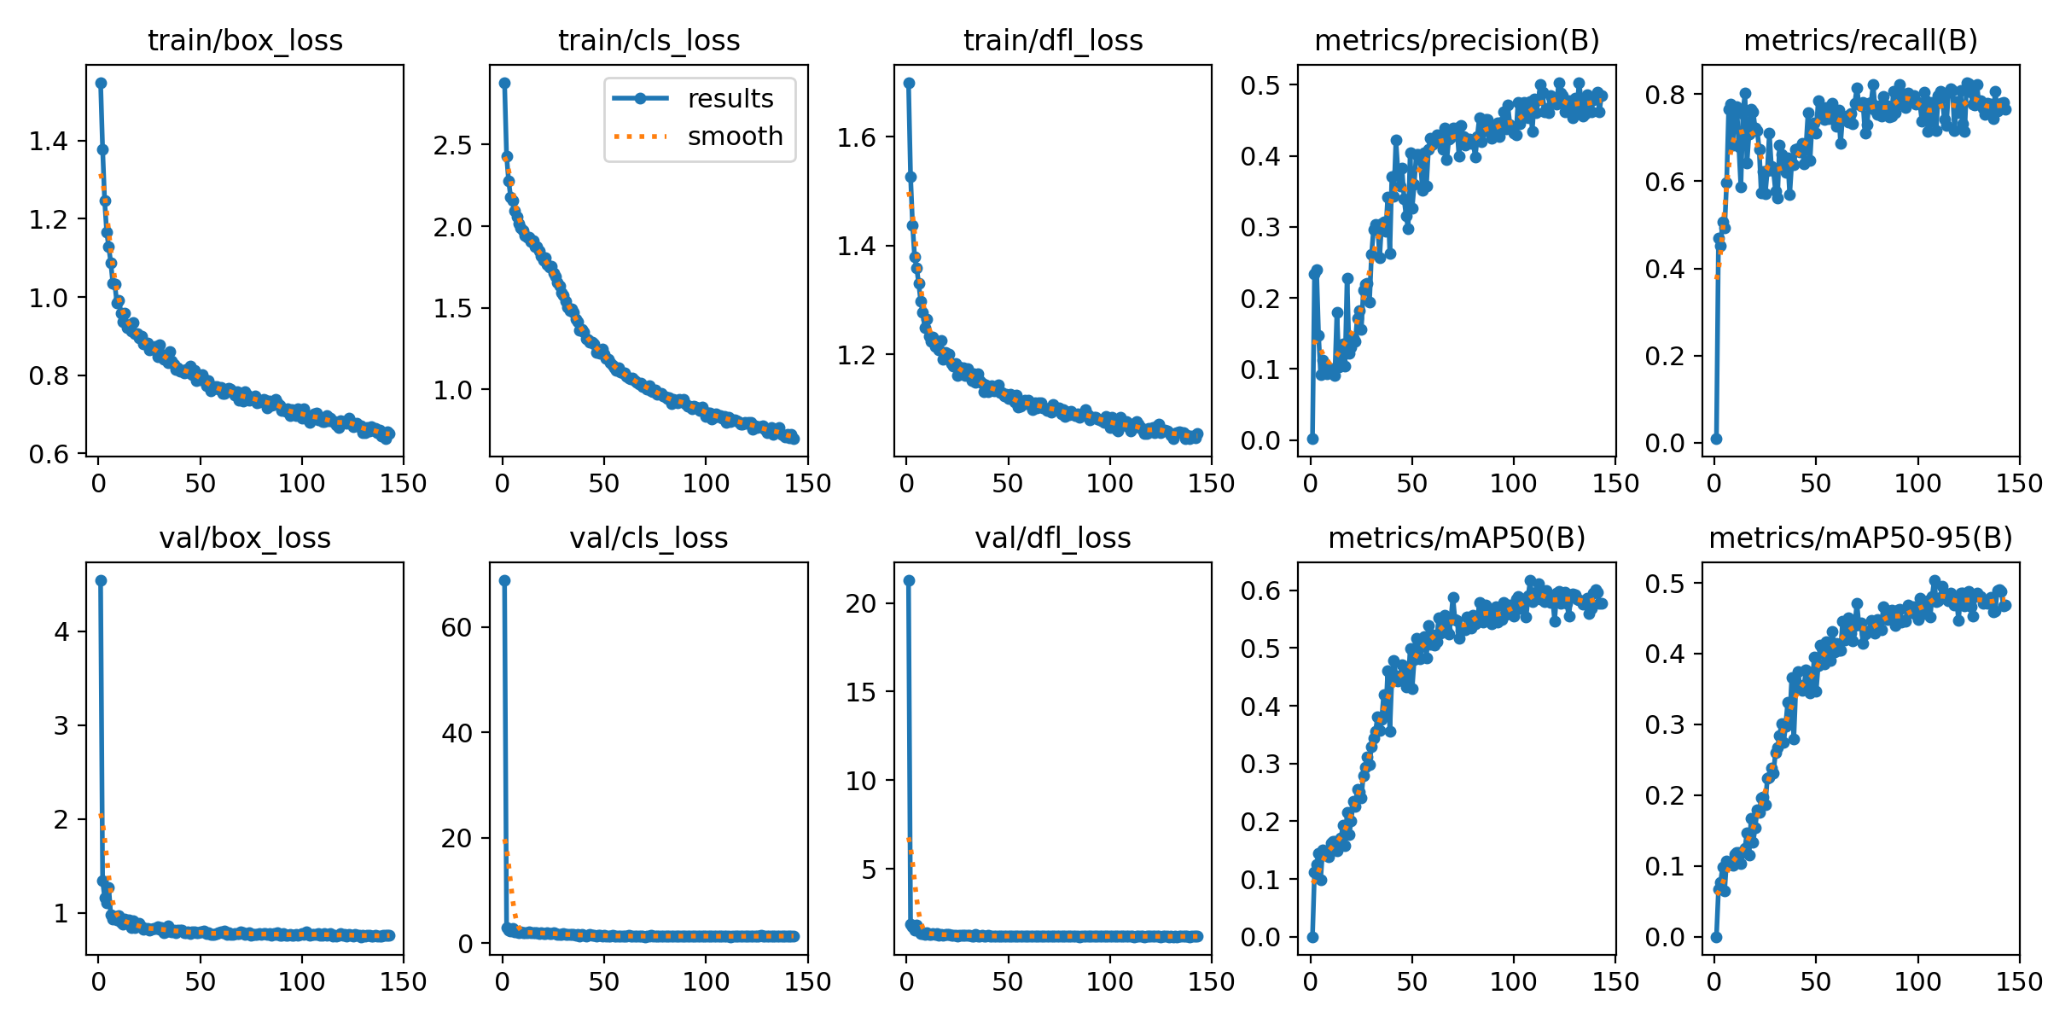
訓練過程將模型預測的車型與位置對照人工標註,計算誤差並更新模型參數。
模型透過訓練學習車身比例、車燈與外觀線條等特徵;若資料缺乏多樣性,仍可能過度依賴特定背景或拍攝角度。
報告使用 640 × 640 的輸入尺寸,並觀察訓練曲線和驗證表現。
模型評估指標
| 指標 | 衡量內容 | 解讀方式 |
|---|---|---|
| Precision | 正確偵測結果占全部偵測結果的比例 | 用於觀察誤報情形。 |
| Recall | 正確偵測結果占實際目標數量的比例 | 用於觀察目標漏檢情形。 |
| F1 | Precision 與 Recall 的綜合表現 | 綜合 Precision 與 Recall。 |
| mAP@0.5 | 各車型的平均偵測表現 | 綜合車型判斷與框選位置;不是逐張答對率。 |
| 混淆矩陣 | 預測車型與實際車型的類別對照 | 比較人工答案與模型預測的類別。 |
成果分析與改善方向
結合評估指標與影像對照,分析辨識表現及主要誤判情形。
整體辨識表現
報告中 F87 M2、G87 M2 的 AP 較高;F44、G42、U06 家族內的部分車款,仍存在明顯誤判。
0.617
整體 mAP@0.5
報告的平均偵測評估指標,不等於 61.7% 的逐張答對率。
0.58
最高 F1 分數
在報告的門檻比較中,兼顧 Precision 與 Recall 的最高綜合表現。
0.206
最高 F1 對應的信心門檻
屬於原報告的評估結果;線上展示預設採 30% 初判門檻,另以 AI 複核,兩者用途不同。
人工標註與模型預測對照
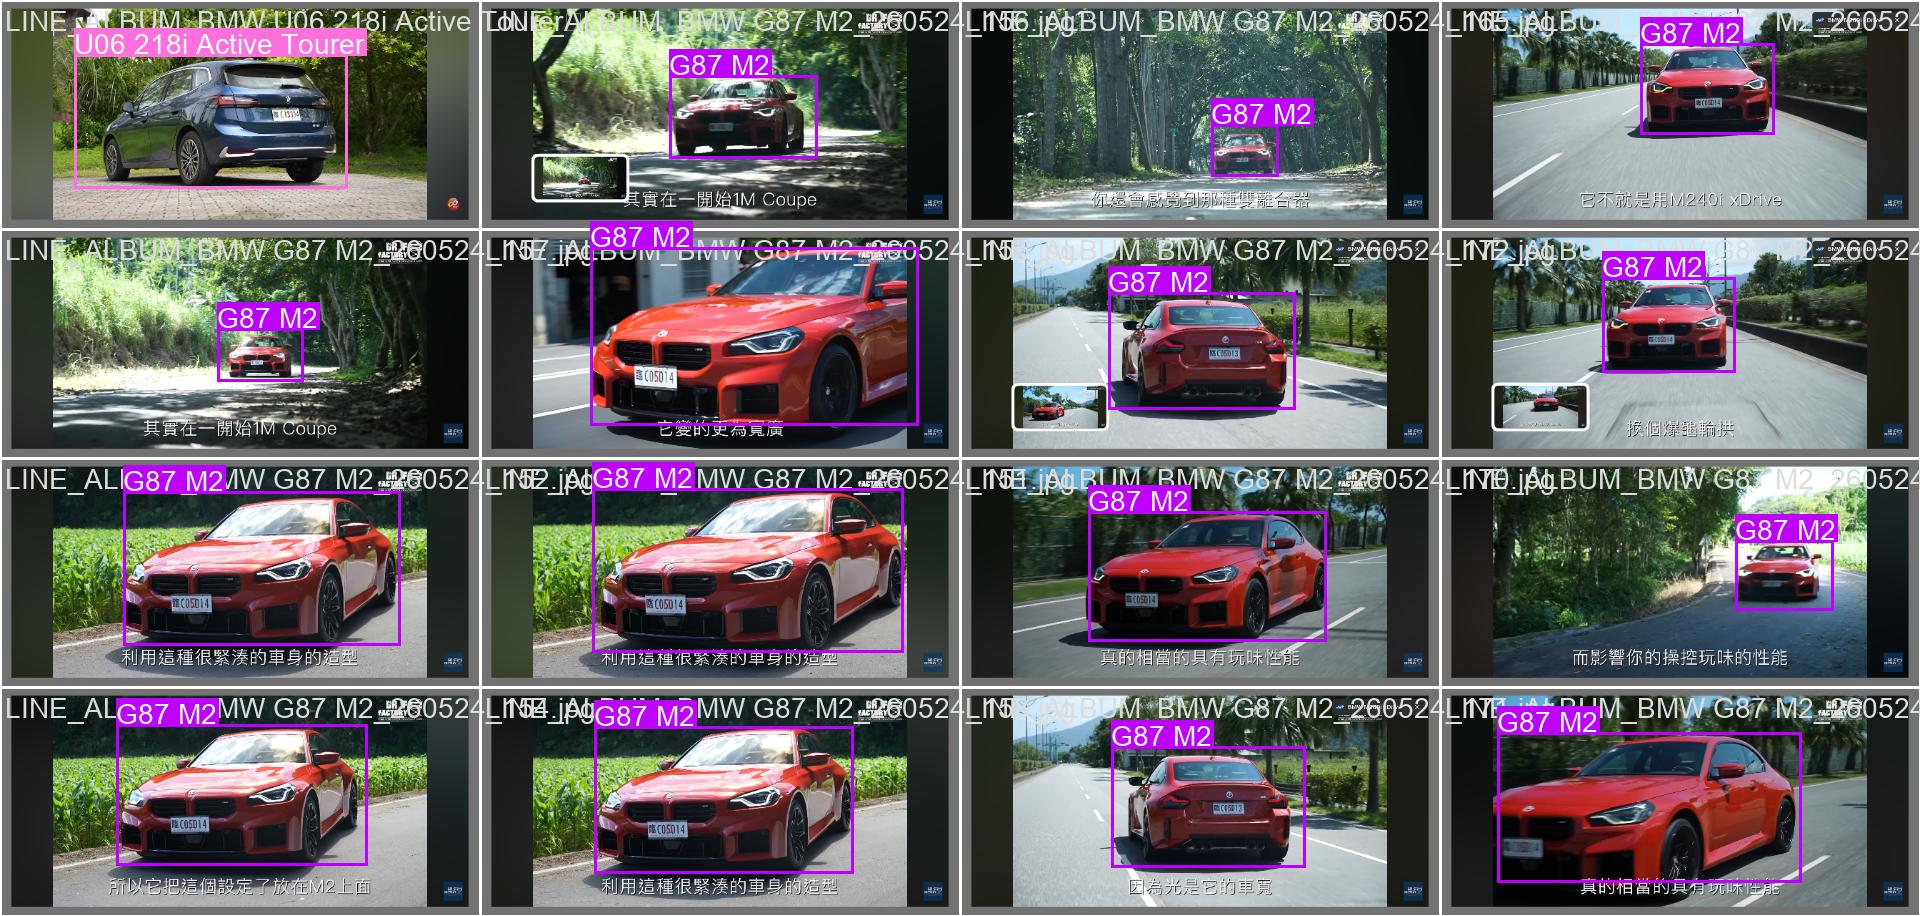
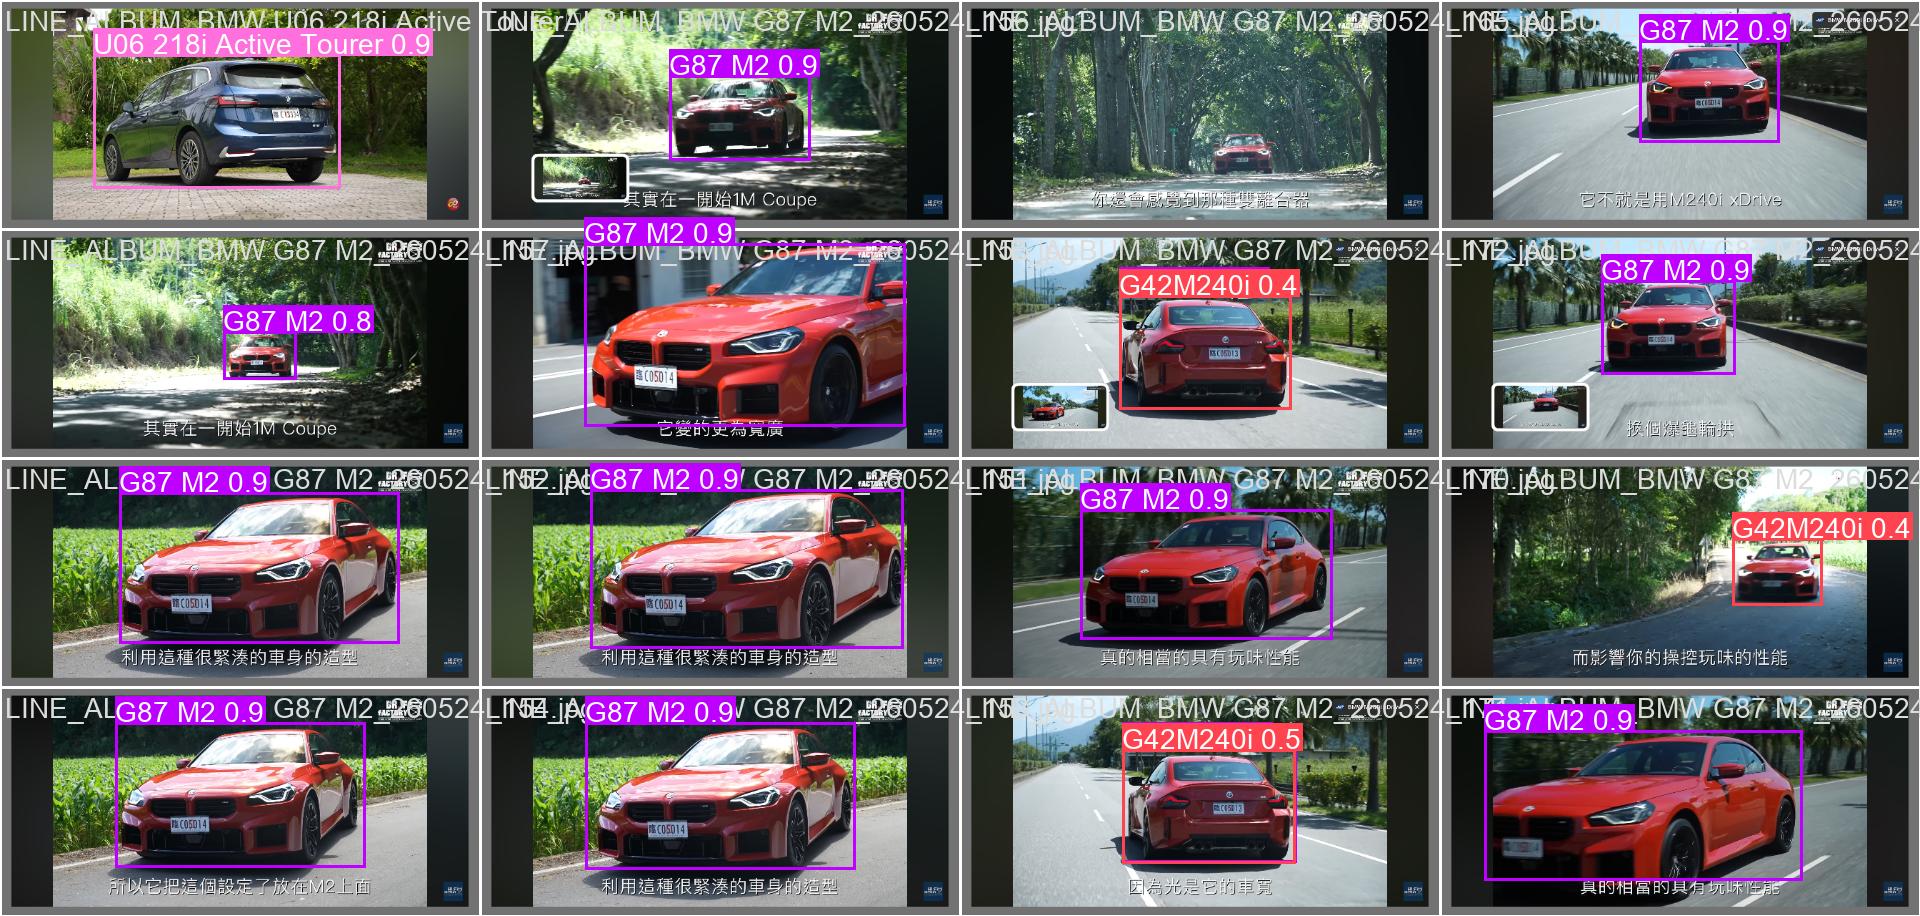
透過人工標註與模型預測的對照,檢查車輛框選位置及車型分類是否一致。即使信心分數較高,仍需檢查預測結果與影像內容是否相符。
各車型表現與混淆分析
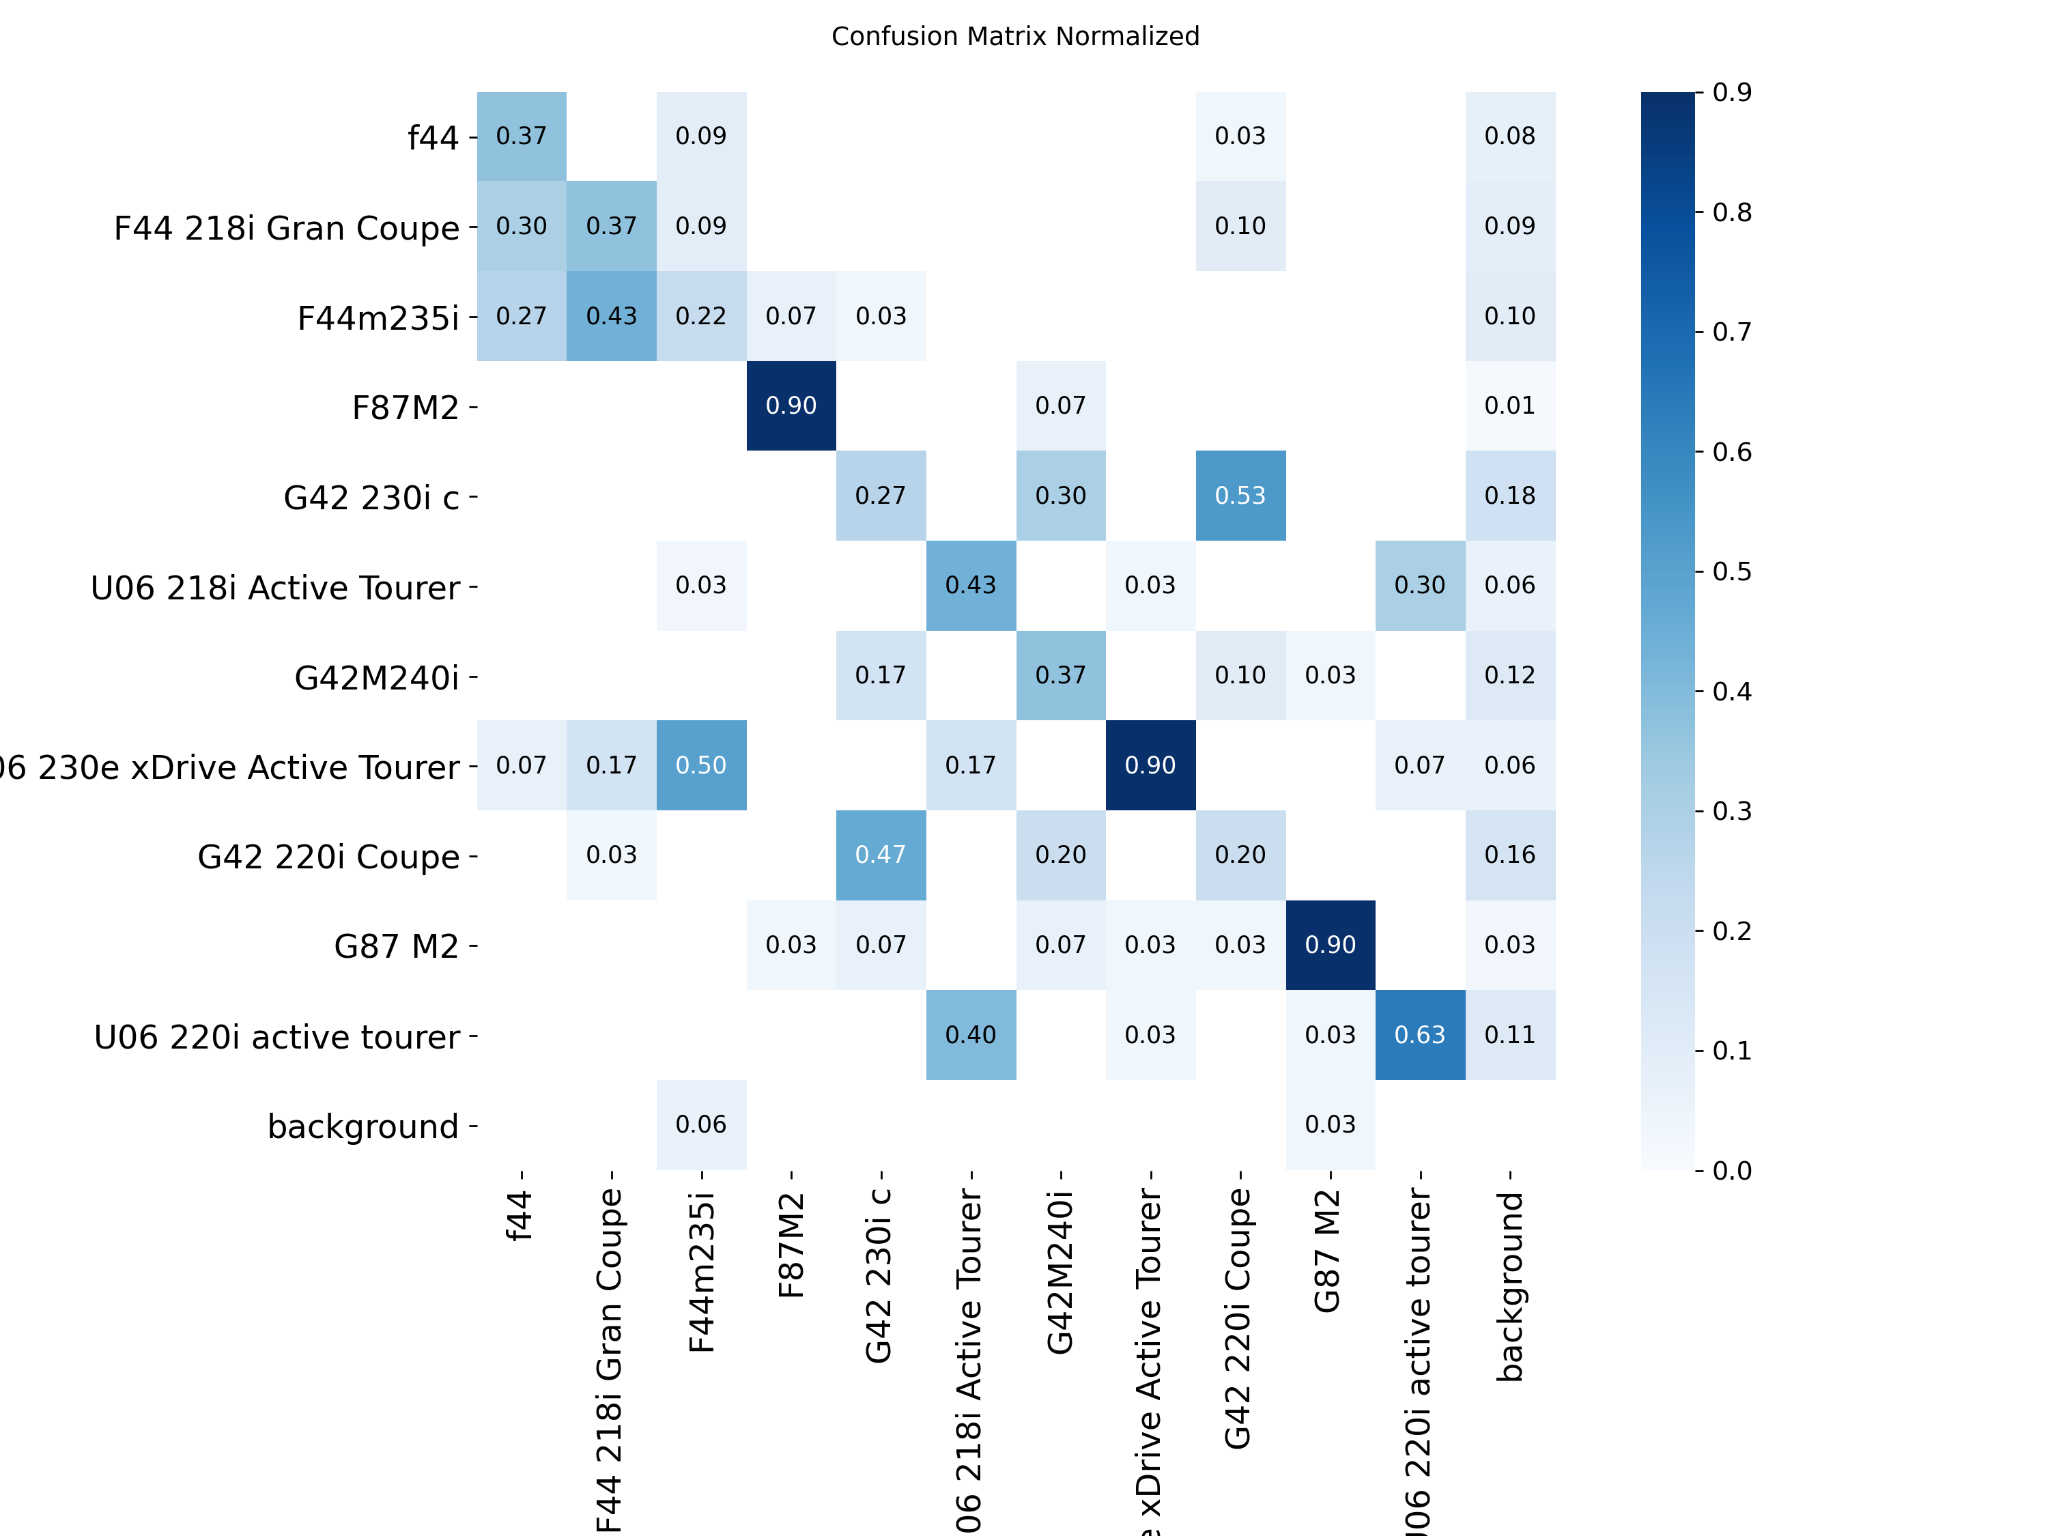
| 車型 | AP |
|---|---|
| F87 M2 | 0.979 |
| G87 M2 | 0.947 |
| U06 230e xDrive | 0.742 |
| F44 220i(原圖 f44) | 0.714 |
| G42 220i | 0.379 |
| F44 M235i | 0.176 |
後續改善方向
相似車型辨識
補充能看清車頭、車尾、銘牌等細節的照片,也可先辨識家族,再細分車款。
影像情境多樣性
增加不同角度、光線、背景與距離,並檢查是否有重複或近似照片。
非目標車輛判斷
後續需要加入非目標車輛資料、建立拒絕判斷方式,再用新的照片驗證。
標註品質與獨立測試
統一框選規則,校正車型名稱,並以未參與訓練的照片檢查改善效果。
網站系統與應用
整合影像上傳、車型辨識與車輛資料查詢,呈現研究應用成果。
系統操作流程
影像上傳
支援 JPG、PNG、WebP,檔案需在 20 MB 以內。車身清晰、完整的照片較適合試用。
車輛偵測與車型判定
YOLO 先找出車輛與最高分候選,再由 AI 獨立檢查廠牌及車型;未確認支援車型則顯示辨識失敗。
辨識結果與資訊呈現
通過 AI 複核後,依車型查出參考新車價、上市年份與規格,並附上來源。
辨識結果與車型資料來源
| 畫面資訊 | 來源 | 說明 |
|---|---|---|
| 車輛框、推測車型、信心分數 | 模型對照片的輸出 | 可能判錯,需要再確認。 |
| 參考新車價與上市年份 | 事先整理的車型資料 | 屬於特定市場與日期的參考資料。 |
| 引擎、馬力、驅動等規格 | 對應車型的資料卡 | 不是模型從照片量測出的數據。 |
使用條件與辨識限制
支援車型範圍
模型仍可能將其他品牌或未收錄車款誤判為支援類別;較高的信心分數並不保證車型判斷正確。
信心分數設定(預設 30%)
可在 20–100% 之間調整。較高門檻會隱藏更多候選結果,也可能漏掉真正的目標車型。
初次載入與執行環境
第一次開始辨識會下載約 97 MB 的模型。等待時間與辨識速度受網路和裝置效能影響。
影像處理與資料傳送
YOLO 在瀏覽器分析照片;按下開始辨識後,縮小照片會送交後台與 OpenAI 進行 AI 複核。本網站不保存照片。
參考文獻與資料來源
研究方法、評估指標與車型資料所依據的文獻與文件。
方法與技術來源
YOLO 原始研究
Redmon, J., Divvala, S., Girshick, R., & Farhadi, A. (2016). You Only Look Once: Unified, Real-Time Object Detection.
理解 YOLO 將位置與類別預測整合到同一個偵測模型的基本概念。
閱讀原始來源 ↗
專題圖表與車型資料
小組專題報告與計畫書
本網站的團隊資訊、資料配置、模型成果圖與數值,整理自小組提供的《車型辨識專題報告》與《BMW 2 Series 車型辨識之研究》計畫書。
車型示意照片沿用報告中的圖片。辨識結果的價格、上市年份與規格,使用既有車型資料卡,並在卡片內標明市場、查詢日期與原始來源。
歷史新車價與不同國家的價格僅供對應車款參考;實際車型與規格仍需確認。